Syno®C 引物合成
 RNA合成
 mRNA合成
 Syno®GS 基因合成
 载体构建
 高通量及DNA文库构建
 CRISPR基因编辑平台
 病毒包装
 基因测序与组学分析
 重组蛋白表达平台
 抗体工程平台
 多肽服务
 生物信息学分析与设计
 CRISPR文库
 合成生物学产品
 ProXpress蛋白快速检测
 CRISPR 质粒

MPRA文库:把调控序列功能做成高通量读数
GWAS鉴定的疾病信号超过90%落在非编码区,但这些序列是否具有调控功能、活性多强,传统报告基因实验一次只能回答一条。MPRA(大规模并行报告基因检测)文库把这件事做成了高通量、可定量的体系,一次实验,数十万条序列同时读出。
MPRA文库有什么优势?不同版本该如何选型?又能用在哪些场景?下面逐一展开。
MPRA文库是什么:核心逻辑与基本结构
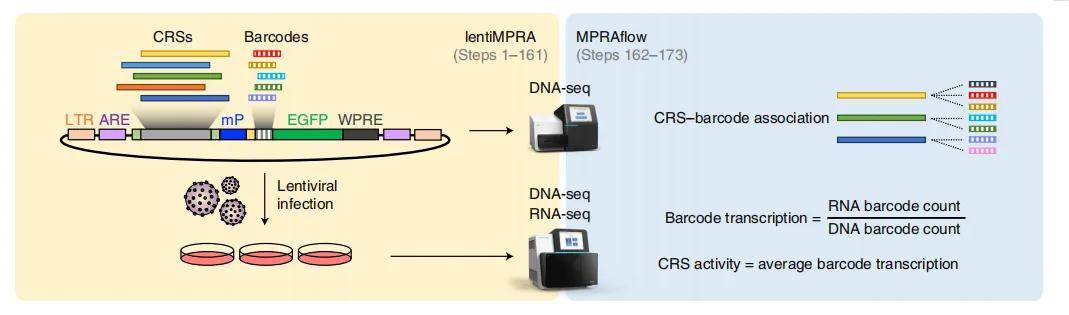
MPRA(Massively Parallel Reporter Assay,大规模并行报告基因检测)的核心逻辑是将调控序列的功能读出转化为可测序的条形码计数。每条候选调控序列(CRS)克隆于报告基因上游,并关联一段条形码;CRS若有调控活性,就会驱动条形码转录。通过比较条形码的RNA计数与DNA计数,以log₂(RNA/DNA)定量该CRS的转录调控活性。成千上万条序列,一次读完。
一个典型的MPRA文库构建体包含:CRS –最小启动子(增强子检测时)–条形码–报告基因。条形码可以位于报告基因的3′ UTR或5′ UTR,也可以通过合成时引入或PCR引物引入,这些设计选择构成了不同MPRA版本的主要差异。
MPRA技术框架始于2009年,Patwardhan等人首次提出以单核苷酸为对象、对启动子进行高通量功能分析的方法。此后十余年,MPRA在条形码位置、递送方式、读出模式上不断分化,形成了不同版本。
版本演进:lentiMPRA的定位与改进
lentiMPRA:用慢病毒将构建体整合进基因组,读出为“基因组内”表达,适用于难转染细胞,结果更可重复;Inoue F等发表于《Nature Protocols》的文章,正是lentiMPRA这一优化版本的标准化实验protocol,系统建立了从文库构建、慢病毒包装、感染测序到MPRAflow数据分析的完整流程。它是lentiMPRA的技术细节来源。
技术优势
-
基因组内读取,定量更稳健。慢病毒整合提供in-genome readout,文献明确指出其比游离型(episomal)MPRA更可重复,且更能被生化注释和序列特征模型预测。两侧ARE配合高条形码冗余,可平均化整合位点位置效应。
-
细胞类型适用范围广。 凡可被慢病毒高效感染的细胞均可开展,突破游离型MPRA对易转染细胞的依赖,覆盖原代细胞、神经元等难转染体系。
-
通量与设计灵活性兼顾。条形码经PCR引入,CRS可由寡核苷酸合成、PCR或DNA捕获等多种方式产生,文库复杂度可在0.5–12百万条形码区间按感染效率与预算调配。
-
分析流程标准化、门槛低。 MPRAflow基于Nextflow,以Anaconda管理环境,提供association、count、saturation mutagenesis三个工具,兼容HPC与云计算,两条终端命令完成分析,并可输出MPRAnalyze所需的广义线性模型输入文件。
-
条形码冗余降低序列内在偏倚。相比STARR-seq以CRS自身作为条形码、可能受RNA结合蛋白和序列RNA稳定性干扰,lentiMPRA平均>50个外源条形码可减少此类偏倚。
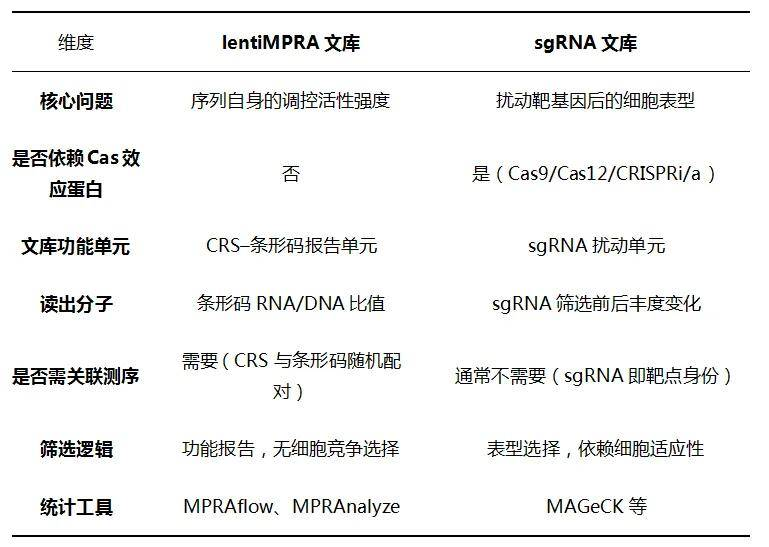
与sgRNA文库的本质差异
二者虽同属慢病毒递送的高通量文库,但扰动对象、读出分子与筛选逻辑均不同。
sgRNA文库问的是:扰动这个基因,细胞会怎样?
sgRNA引导Cas蛋白切割或调控靶基因,通过筛选前后sgRNA丰度的变化,推断哪些基因影响存活或表型。sgRNA既是工具,也是读数,通常不需要关联测序。
MPRA文库问的是:这段DNA序列,调控功能有多强?
CRS驱动条形码转录,读出的是RNA/DNA比值。CRS和条形码是随机配对的,所以必须先做关联测序,把每个条形码“认领”给对应的CRS,才能定量。它不依赖Cas蛋白,也不涉及细胞竞争筛选,本质是一个功能报告系统。
应用领域
1.非编码变异的功能验证与精细定位
GWAS和全基因组测序鉴定出大量非编码候选变异,但连锁不平衡使因果SNP难以判断。MPRA可并行测试同一locus下的所有候选等位基因,直接比较调控活性。近年已用于精神疾病共享遗传变异、奶牛泌乳性状eQTL/组蛋白修饰QTL等场景的精细定位。
2.调控序列“解码”与机器学习模型训练
MPRA产生的高通量序列–活性数据是训练预测性模型的理想素材,用于定量理解顺式调控密码,并对训练集之外的序列进行泛化预测。
3.合成生物学与治疗应用
MPRA-informed模型被用于设计具有特定表达强度或细胞类型特异性的合成调控元件,应用场景涵盖微生物合成生物学、mRNA疗法和精准基因调控。
4.增强子–基因调控网络构建。
将MPRA测得的调控活性整合到增强子–基因相互作用预测模型中,构建高分辨率调控网络,解析非编码变异与基因调控机制的联系。
5.特殊调控机制的高通量解析
MPRA变体也被用于研究特定调控层面,如Vex-seq评估变异对pre-mRNA剪接的影响,mStarrSeq鉴定甲基化依赖的调控元件。
泓迅生物:MPRA文库的合成与构建
MPRA文库落地的核心门槛之一,是大规模CRS寡核苷酸池的合成质量与后续文库构建的完整性。泓迅具备MPRA文库合成与构建的一站式服务能力,覆盖MPRA项目完整链条中从CRS寡核苷酸池合成、条形码引入,到质粒文库构建,测序的全流程服务。
在合成层面,泓迅可支持百万条量级寡核苷酸序列的平行合成,目标序列可达覆盖度99%,能够满足MPRA文库对CRS池复杂度与均一性的要求。
如果您的课题正需要构建MPRA文库,或对CRS池合成与质粒文库构建有需求,欢迎联系泓迅生物,让我们帮您把文库这一关跑通。
参考文献
[1] Inoue F, Martin B, Schubach M, et al. A systematic comparison reveals substantial differences in chromosomal versus episomal encoding of enhancer activity. Nature Protocols, 2020, 15: 2387–2412.
[2]Patwardhan RP, Lee C, Litvin O, Young DL, Pe'er D, Shendure J. High-resolution analysis of DNA regulatory elements by synthetic saturation mutagenesis. Nat Biotechnol. 2009 Dec;27(12):1173-5.